小说解析 1.0 → 1.5.1:把网页装进 App,然后决定停掉它
项目已停止维护。本文只讨论工程实现、产品取舍和停更原因,不提供抓取受版权保护内容或绕过登录、付费墙的方法。项目运行期间也只处理公开可访问章节,不绕过任何登录或付费限制。
起因
做“小说解析”的起点很简单:我平时会在网页上找书、看目录、挑章节,但网页阅读的体验很割裂——搜索、目录、正文、导出分别散在不同页面,手机上还要反复切换应用。于是我想验证一个想法:能不能把“找书 → 看目录 → 阅读 → 导出”收进一个 Android App 里,让网页只负责提供公开内容,App 负责把它整理成可读、可保存的本地资料。
项目从 1.0 做到 1.5.1,功能越来越多,最后却停掉了。这篇文章既是一个复盘,也算给这段折腾一个交代。
它到底做了什么
到 1.5.1 时,项目已经不是一个简单的网页壳:
找书:按书名、作者搜索,结果列表里可以直接打开目录或复制分享链接。
书架:把正在看的书放进本地书架,记录阅读进度。
阅读器:字号、行距、背景、主题可调,支持上下章切换和阅读位置记忆。
导出:把已获取的公开章节导出为 TXT、EPUB 或 PDF,方便离线保存。
更新与公告:App 内置更新源,启动时检查版本;公告和反馈板放在网页端。
网页版 + Android App:同一套页面既能在浏览器里用,也能被 App 的 WebView 加载。
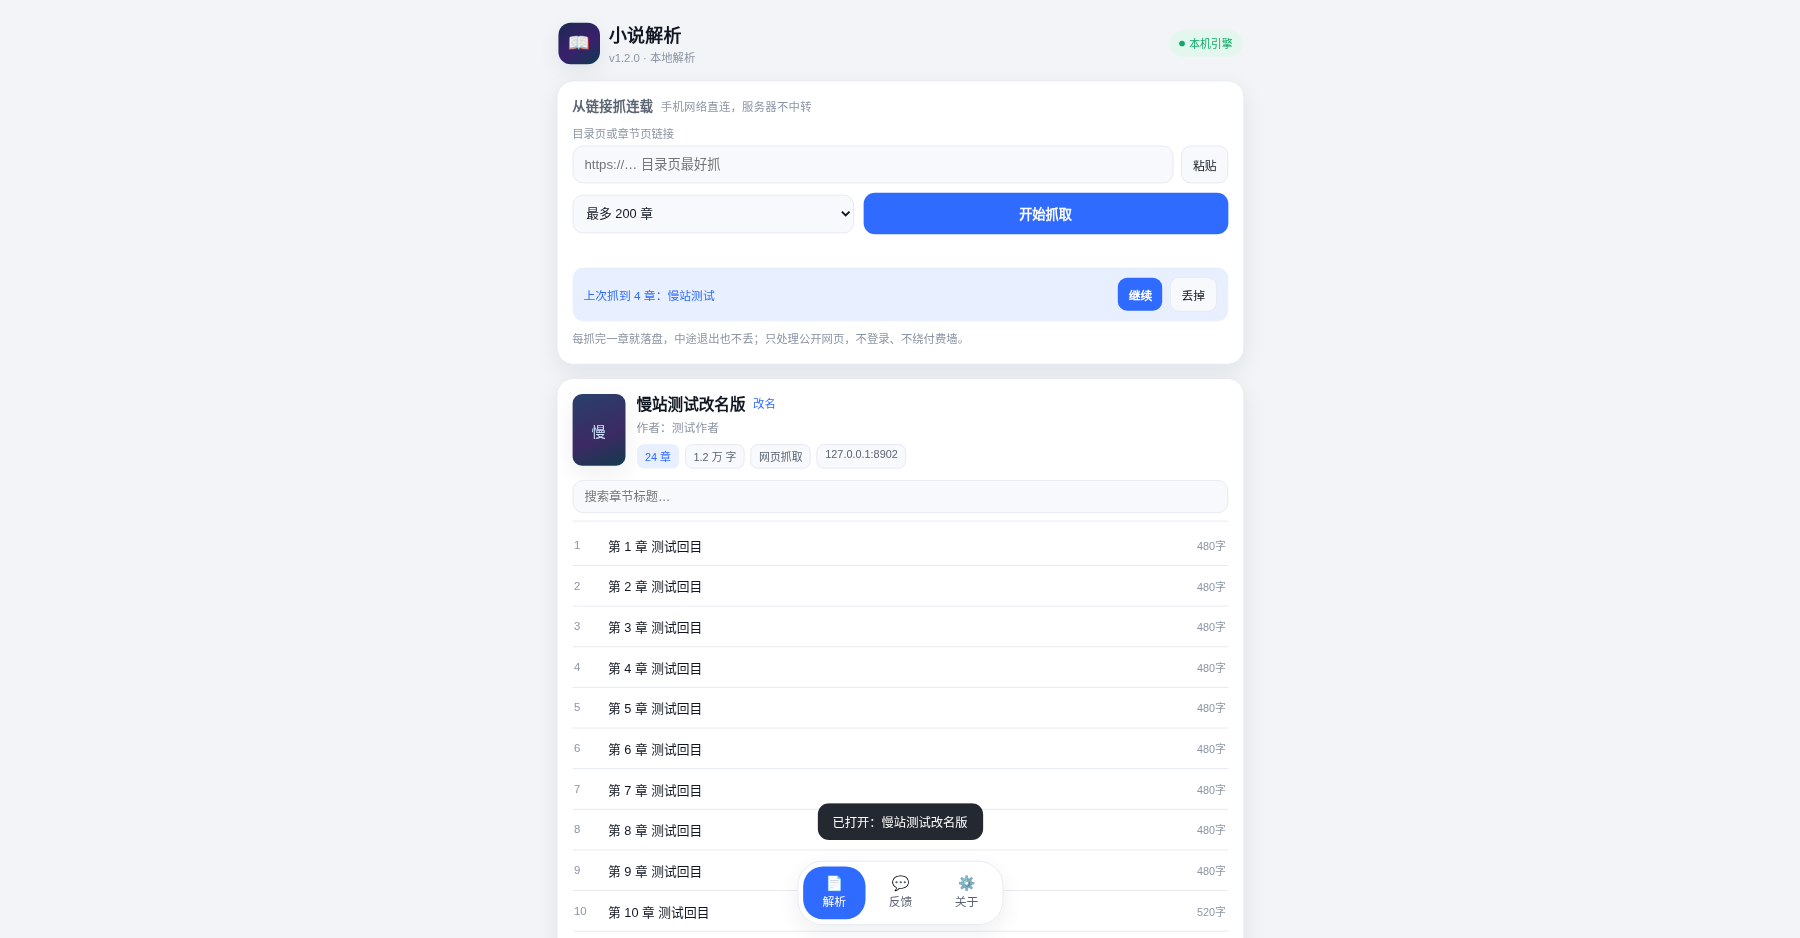
从产品角度看,它解决的是“信息整理”而不是“内容获取”:搜索、目录、阅读器、导出、书架,都是围绕已经公开可访问的章节做体验优化。
技术结构
整体是一个很典型的“轻客户端 + 本地服务”结构:
Android 壳:负责安装包、权限、文件选择、分享、打开外部应用,以及 WebView 容器。
本地 Python 服务:在 App 内跑一个仅监听本机的小服务,处理搜索、目录、章节整理、导出和文件落盘。这样网页端和 App 端可以共用一套接口。
前端页面:用 WebView 加载,桌面浏览器也能直接访问网页版;主题、阅读器、书架都在前端完成。
本地数据:书架、阅读进度、导出记录和设置都存在本机,尽量不依赖云端账号。
更新源:用
update.json做版本检查,只有真的出新版本才提示;反馈板则是一个独立的小服务。
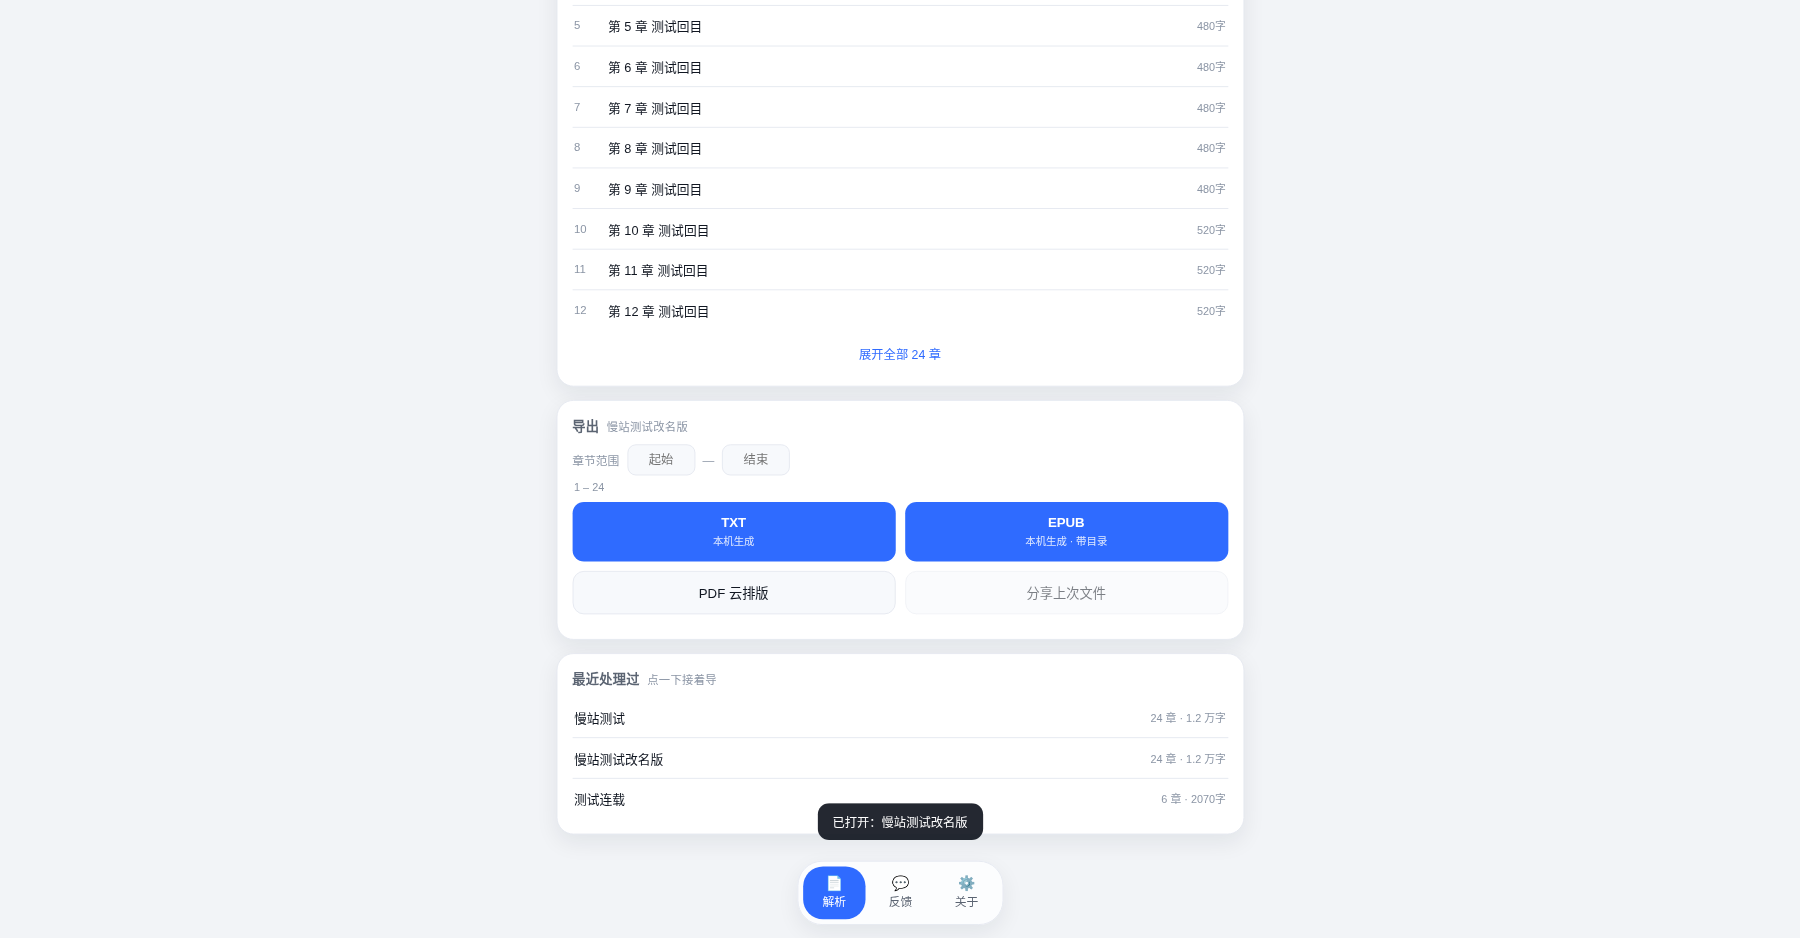
这套结构的好处是“离线优先、数据在本地”;坏处也很明显:Android 端要同时维护壳、本地服务、前端和打包签名,任何一个环节出问题,用户看到的都是“App 打不开”或“导出失败”。
最难的不是抓页面
真正做过之后,最难的并不是“把页面拿下来”,而是下面这些事:
页面结构会变。今天能用的选择器,明天可能因为站点改版就失效;靠外部页面结构吃饭的功能,天然不稳定。
章节边界很模糊。一本书的目录可能有 129 章,但公开可读的只有 10 章,其余 119 章处于锁定状态。App 可以展示完整目录,但不能把锁定章节当成可下载内容;这不是技术问题,是产品边界问题。
用户预期很容易被拉高。只要目录里能看到 129 章,用户就会默认“应该都能导出”;一旦发现只能处理公开章节,体验就会落差。与其反复解释,不如一开始就把能力边界写清楚。
维护成本被低估。搜索、目录、阅读器、导出、书架、更新、反馈板,每个模块都要单独测试;网页端和 App 端还要保持一致。功能越多,停更时越难割舍。
这也是我后来不再把“解析”当成核心卖点的原因:它建立在一个不稳定的外部依赖上,而且天然会触碰版权和平台规则的边界。
为什么决定停掉
停掉不是某一个瞬间的决定,而是几个问题叠加后的结果:
合规边界:小说内容有明确的版权归属,公开章节可以阅读,但不等于可以批量抓取、重新分发或做成下载器。继续做下去,产品很容易从“阅读辅助”滑向“内容搬运”。
产品边界:我不想把“能拿到多少章”当成卖点,也不愿意做绕过登录或付费墙的功能。把边界写死之后,剩下的功能其实更接近一个普通阅读器,而不是“解析器”。
维护成本:站点结构、反爬策略、章节状态都会变;每次变化都要重新验证搜索、目录、正文和导出。对个人项目来说,这个维护频率不划算。
分发风险:APK 一旦公开,版本、签名、更新源、反馈入口都要长期负责;停更比继续发版更需要勇气。
所以最后的选择是:小说解析彻底放弃,不再提供下载和入口;网页版、App、后端服务和反馈板一起归档。 我没有保留“以后有空再修”的念头,因为只要入口还在,就会有人继续期待它“什么都能下”。
做对了什么,没做好什么
做对的地方:
本地优先:书架、进度、导出文件都在本机,用户对自己的数据有控制权。
一套内容,多端复用:网页版和 App 共用页面与接口,减少重复实现。
更新与反馈闭环:
update.json+ 公告 + 反馈板,至少让版本迭代有地方说话。视觉一致性:阅读器主题、底栏、卡片和设置页尽量统一,不把“功能多”做成“页面乱”。
没做好的地方:
功能贪多:搜索、书架、阅读器、导出、反馈板同时推进,每个都只做到“能用”,没有做到“稳定”。
边界表达太晚:应该更早把“只处理公开章节”写在首屏,而不是等用户点了锁定章节才解释。
过度依赖外部页面:搜索和目录都建立在站点结构上,站点一改,测试成本立刻上升。
停更流程不完整:直到决定放弃,才真正开始做归档、下架和入口清理;如果早点做,能省下不少解释成本。
给后来者的几句话
不要在一个脆弱的外部页面上盖太多功能。 搜索、目录、阅读器、导出,每加一层,维护成本都会翻倍。
把“不能做什么”写在产品里。 只处理公开内容、不绕过登录、不提供锁定章节,这些边界越早说清楚,越不容易被误解。
更新源和签名要当成产品的一部分。 很多个人 App 不是死在功能,而是死在版本混乱和更新失败。
停更也是一种产品决策。 归档、下架、写清楚原因,比留一个半死的入口更负责。
图片和文档要有自己的落脚点。 这次我把文章配图迁到了自建图床
img.foldx.cn,不再依赖第三方临时链接。
项目归档与 GitHub
这个项目已经停止维护。GitHub 上保留的是复盘文档和架构说明,不包含抓取实现,也不提供 APK 下载:
GitHub: https://github.com/foldx-cn/novel-parse-pro-retrospective
如果你只是想要一个本地阅读器,未来也许可以做一个不依赖外部站点的版本;但“小说解析”这个名字和这套入口,就到这里了。
作者:Sienna Fuca · 2026-11-14标签:项目复盘 / Android / Python / 小说解析 / 停止维护
制作手记:它是怎么跑起来的
这一节补上“制作”本身:不是功能清单,而是这套东西怎么被拼起来、哪里最容易出问题。项目结构其实很朴素——Android 单 Activity + 只监听 127.0.0.1 的本地 Python 服务 + WebView 前端。先把三层定下来,搜索、书架、阅读器、导出才有地方放。
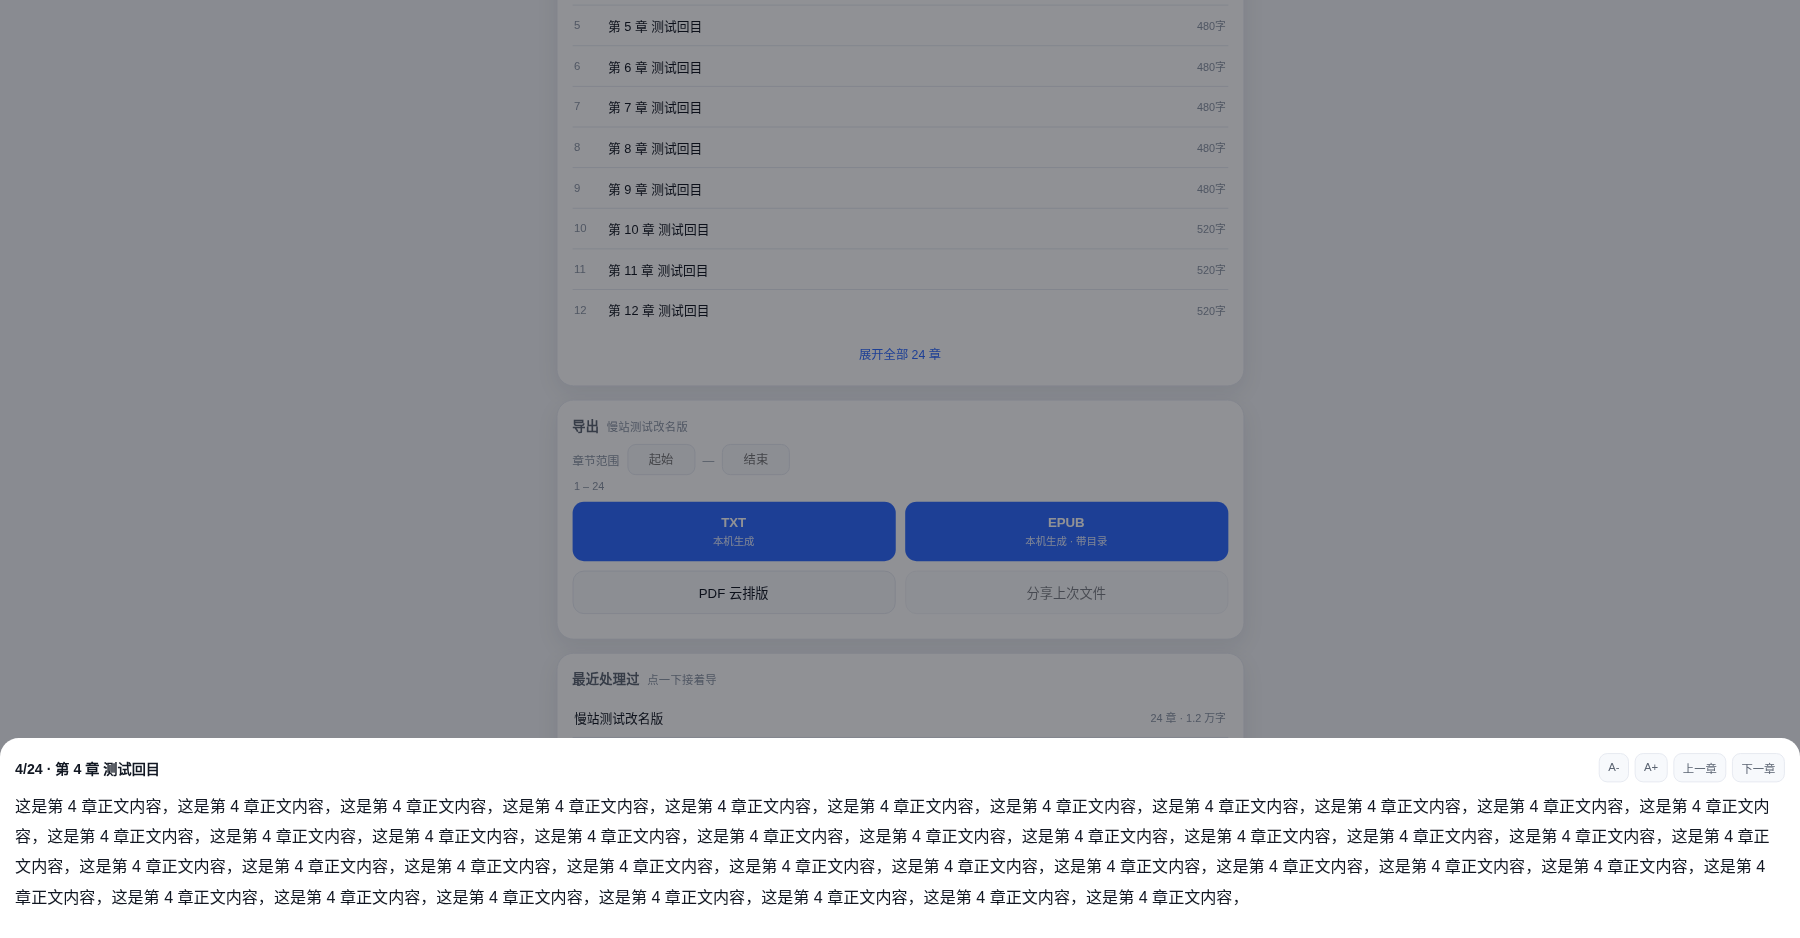
Android 壳只做四件事:启动本地服务并拿到端口、创建 WebView、处理系统文件选择/保存/分享、在 Activity 生命周期里启动和停止服务。业务逻辑不塞进 Activity,前端才能独立迭代。
本地服务用 Python 标准库的 ThreadingHTTPServer,只绑定回环地址。接口包括健康检查、当前书籍、章节正文、导出、书架和最近记录。所有数据留在手机上,不依赖云端账号;抓取、阅读、导出可能并发,所以书籍状态和章节列表要加锁,文件写入先写临时文件再原子替换。
前端是一个单文件 HTML,不引框架,状态放在普通对象和 localStorage 里。书架、找书、解析、反馈、关于五个底部 Tab;阅读器支持字号、行距、背景、主题、上下章和位置记忆。TXT 导出直接按章节拼接;EPUB 生成 mimetype、目录、章节 XHTML 和封面后打包;PDF 走云端排版,因为中文字体嵌入和分页在手机上做不稳。
打包用 Chaquopy 把 Python 3.11 打进 APK,只保留 arm64-v8a;Gradle 配置 versionCode / versionName,每次发版同时更新 update.json。这次整理开源包时特意删掉了 build.gradle 里的 signingConfigs:keystore、storePassword、keyPassword 不应该进公开仓库。
真正难的是边界。技术上把网页内容读出来并不难,难的是决定哪些内容不该读。目录里能看到 129 章,不等于 129 章都能导出;公开可读的 10 章和锁定的 119 章,是产品边界,不是技术边界。所以 1.5.1 之后没有再发版,网页版、App、后端服务和反馈板一起归档。
图床:文中截图放在自建图床 img.foldx.cn,继续保留 /i/ 直链;图床前端也换成了与博客同风格的蓝白玻璃界面和图形化控制台。
开源了什么:GitHub 上保留复盘文档,以及一个可复用的客户端/界面源码包——Android 壳、WebView 界面、资源、Gradle 配置和架构说明。可直接取用:novel-parse-pro-ui-source.tar.gz。
没有开源什么:站点目录/正文适配、字体映射、搜索/抓取模块、登录/Cookie/付费墙处理、签名 keystore 和 APK。原因很直接:这些模块拼在一起,就是一个可以直接复用的内容抓取器;开源应该把可复用的产品结构留下,而不是把边界拆掉。
如果你只是想做一个本地阅读器,这个包里的 WebView 容器、阅读器布局、书架和导出交互都可以直接参考;后端换成自己的本地文件解析即可。